Kurz beantwortet: Ein A/B-Test vergleicht zwei Varianten einer Seite oder eines Elements an echten Besuchern, die zufällig und gleichzeitig verteilt werden. Aussagekräftig wird er, wenn vor dem Start Hypothese, Kennzahl und nötige Besucherzahl feststehen. Außerdem darf der Test nicht vorzeitig enden. Für Seiten mit wenig Traffic lohnt sich meist erst die qualitative Analyse.
Ein neuer Button, eine andere Überschrift, ein kürzeres Formular: Fast jede Änderung an einer Website beruht zunächst auf einer Vermutung. Der Test prüft diese Vermutung, bevor sie dauerhaft Anfragen oder Umsatz beeinflusst. Er kann aber auch Scheinsicherheit erzeugen, wenn Laufzeit und Stichprobe nicht stimmen. Unten finden Sie den Ablauf, ein Rechenbeispiel und die Regeln für Auswertung und SEO.
Was ist ein A/B-Test?
Ein A/B-Test, englisch A/B-Testing, ist ein Experiment, bei dem Version A (die Kontrolle) und Version B (die Variante) gleichzeitig an unterschiedliche Besuchergruppen ausgespielt werden. Die Zuteilung erfolgt zufällig. Eine zuvor festgelegte Kennzahl entscheidet, welche Version besser abschneidet, zum Beispiel die Rate abgeschickter Kontaktformulare.
Wichtig ist die Gleichzeitigkeit. Schaltet jemand Version B einfach nach Version A und vergleicht die Wochen, fließen Saison, Werbedruck und Zufall in das Ergebnis ein. Hier sehen beide Gruppen dieselben Bedingungen. Die Zufallsverteilung sorgt dafür, dass sich die Gruppen bis auf die Änderung gleichen. In der Praxis begegnet Ihnen auch die Schreibweise AB-Test.
Verwandte Verfahren grenzen sich so ab:
- Split-URL-Test: Die Varianten liegen auf getrennten Adressen. Das eignet sich für große Umbauten, etwa eine neue Seitenvorlage.
- Multivariater Test: Mehrere Elemente werden gleichzeitig kombiniert, etwa Überschrift und Bild. Das braucht deutlich mehr Besucher, weil jede Kombination eine eigene Gruppe bildet.
- Personalisierung: Unterschiedliche Gruppen sehen dauerhaft unterschiedliche Inhalte. Das ist kein Test, sondern eine Ausspielungsregel.
Im Rahmen der Conversion-Optimierung prüft er eine Hypothese aus der Analyse. Die Analyse selbst, zum Beispiel mit Tracking und Heatmaps, kommt davor. Einen Überblick über das Gesamtfeld gibt der CRO-Leitfaden.
Wann sich ein Test lohnt
Viele Seiten eignen sich nicht. Ein Test braucht genug Besucher und Conversions, damit sich ein Unterschied vom Zufall abhebt. Die Tabelle ordnet typische Lagen ein. Sie ist eine Empfehlung aus unserer Praxis, keine Messgröße.
| Ausgangslage | Empfehlung | Begründung |
|---|---|---|
| Viele Besucher, klares Ziel wie Formular oder Kauf | Testen | Die Stichprobe wird in überschaubarer Zeit erreicht |
| Wenige Besucher, wenige Anfragen | Qualitative Analyse zuerst | Nutzerinterviews, Usability-Tests und Experten-Reviews liefern auch ohne große Zahlen Hinweise |
| Offensichtlicher Fehler, etwa ein defektes Formular | Direkt beheben | Ein Fehler braucht keinen Test, nur eine Korrektur |
| Mehrere Ideen gleichzeitig, kaum Daten | Priorisieren, dann nacheinander testen | Zu viele parallele Varianten verwässern jede einzelne Gruppe |
Der Ablauf in fünf Schritten
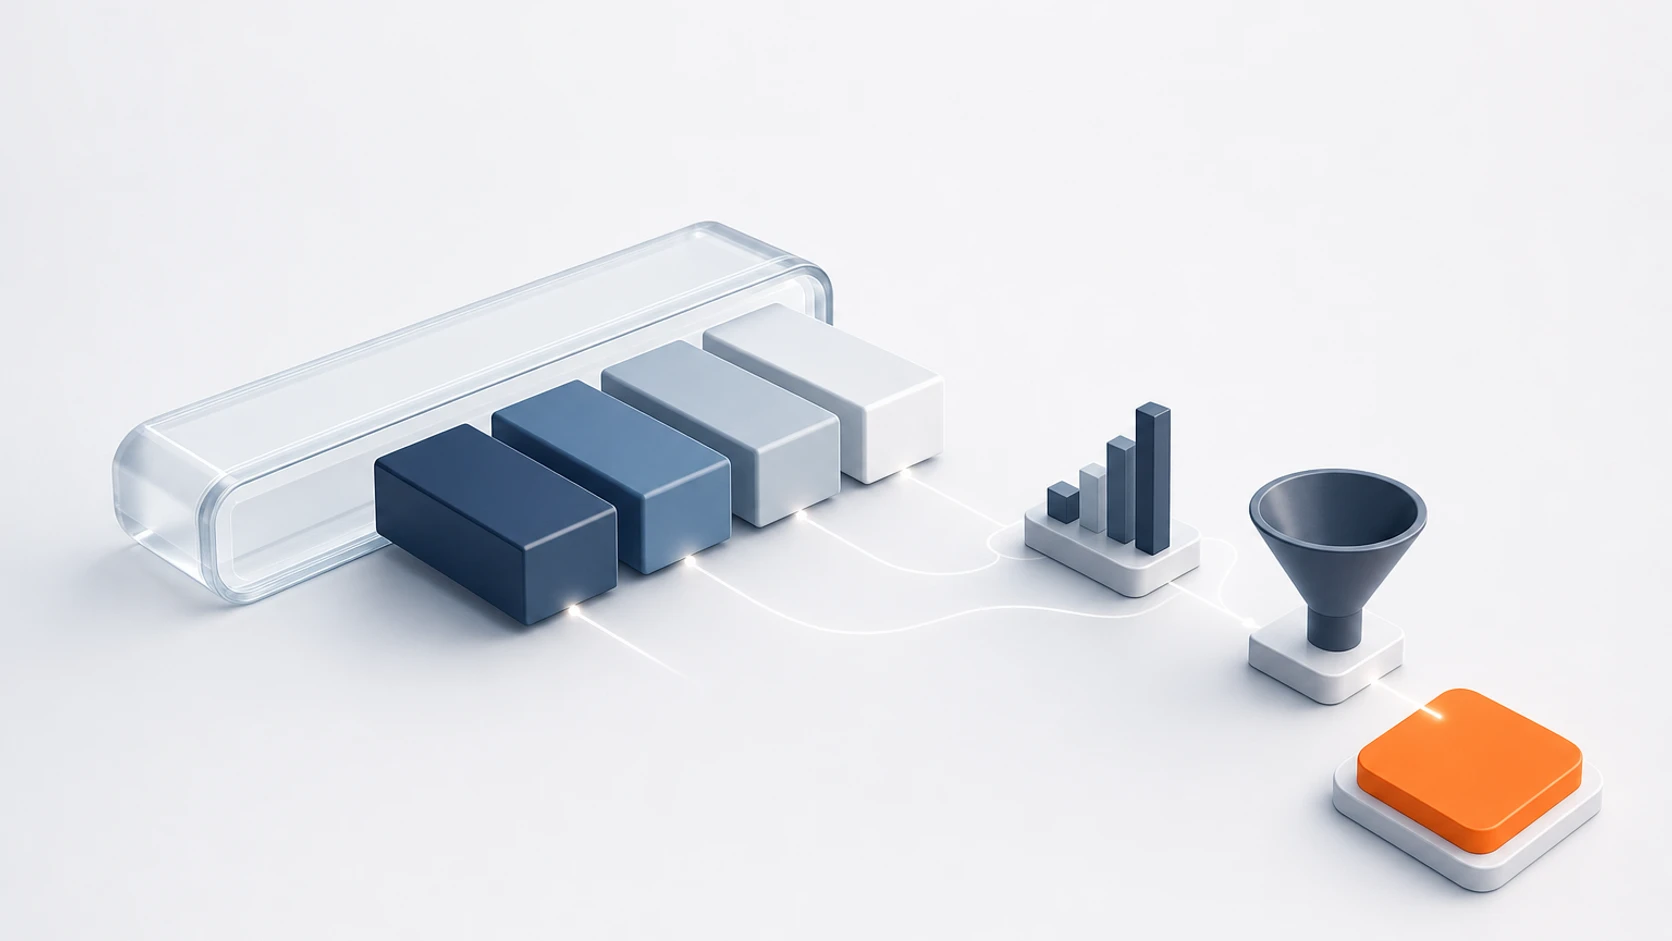
Ein sauberer Test folgt einer festen Reihenfolge. Die Grafik zeigt sie, darunter steht jeder Schritt im Detail.
1. Hypothese formulieren
Eine Hypothese nennt Änderung, Begründung und erwartete Wirkung. Beispiel: „Wenn wir das Kontaktformular von sieben auf vier Felder kürzen, schicken mehr Besucher es ab, weil die Hürde sinkt.“ Eine Idee ohne Begründung ist noch keine Hypothese. Die Begründung stammt idealerweise aus Daten: Abbrüche im Formular, Klickverhalten oder Rückmeldungen aus dem Vertrieb.
2. Kennzahl festlegen
Wählen Sie eine Hauptkennzahl, die zum Geschäftsziel passt, etwa abgeschickte Anfragen je Besucher. Nebenkennzahlen wie Absprungrate dienen der Kontrolle. Wechseln Sie nach dem Test zu der Kennzahl, die gerade besser aussieht, ist es kein Experiment mehr. Die Messung setzt sauberes Tracking voraus, wie es unser Beitrag zum Google Tag Manager beschreibt. Je nach Einwilligungsquote hilft zusätzlich Server-Side-Tracking, damit weniger Ereignisse verloren gehen.
3. Stichprobe berechnen
Die Besucherzahl legen Sie vor dem Start fest. Dazu brauchen Sie die bisherige Conversion Rate und den Effekt, den Sie mindestens nachweisen wollen. Das Rechenbeispiel folgt im nächsten Abschnitt.
4. Test aufsetzen und prüfen
Bauen Sie Variante B so, dass sie sich in der getesteten Änderung unterscheidet und sonst nicht. Prüfen Sie vor dem Start beide Versionen auf Mobilgeräten und in gängigen Browsern. Kontrollieren Sie, dass die Kennzahl in beiden Varianten gemessen wird. Ein Test, bei dem Variante B kurz flackert oder das Tracking auslässt, liefert verzerrte Daten.
5. Laufen lassen und auswerten
Der Test läuft, bis die geplante Stichprobe erreicht ist. Er umfasst volle Wochen, damit die Wochentage gleich oft vorkommen. Erst danach werten Sie aus. Die Auswertung beschreibt der übernächste Abschnitt.
Stichprobe und Laufzeit: ein Rechenbeispiel
Als Faustregel nennt Evan Miller in seinem Beitrag „How Not To Run an A/B Test“ die Formel n = 16 × σ² / δ² je Variante. Dabei ist δ der relevante Mindestunterschied und σ² bei einem Anteilswert p(1 − p). Die Formel liefert eine Größenordnung, kein exaktes Ergebnis.
Ein Beispiel: Ihre Seite hat eine Conversion Rate von 3 Prozent (p = 0,03). Sie wollen einen Anstieg um 0,6 Prozentpunkte nachweisen (δ = 0,006).
- σ² = 0,03 × 0,97 = 0,0291
- n = 16 × 0,0291 / 0,006² = 0,4656 / 0,000036 ≈ 12.900 Besucher je Variante
Beide Varianten zusammen brauchen also rund 25.800 Besucher. Suchen Sie dagegen einen großen Effekt von 1,5 Prozentpunkten (δ = 0,015), sinkt der Bedarf auf etwa 2.100 Besucher je Variante. Je kleiner der erwartete Unterschied, desto mehr Besucher sind nötig. Teilen Sie die Gesamtzahl durch den täglichen Traffic der getesteten Seite. So erhalten Sie die Mindestlaufzeit. Runden Sie auf volle Wochen auf.
Unsere Erfahrung ist, dass Tests auf Seiten mit mittlerem Traffic zwei bis acht Wochen brauchen. Das ist ein Richtwert aus der Praxis. Er hängt von Ihrem Traffic und dem erwarteten Effekt ab.
Auswertung: Was das Ergebnis aussagt
Die Signifikanz gibt an, wie oft ein solcher Unterschied ohne echten Effekt zufällig auftreten würde, üblich sind 5 oder 1 Prozent. Ein Testtool zeigt oft das Gegenstück an, etwa „95 Prozent Wahrscheinlichkeit, das Original zu schlagen“. Beide Werte setzen voraus, dass die Stichprobe vorab feststand.
Ein verbreiteter Fehler ist das vorzeitige Beenden. Miller beschreibt: Wer den Test laufend prüft und beim ersten signifikanten Wert stoppt, erhöht die Rate falsch positiver Ergebnisse. In seinem Rechenbeispiel mit einer wirkungslosen Änderung, bei dem der Test bei Signifikanz oder nach 150 Beobachtungen endet, liegt die Fehlerquote bei 26,1 Prozent statt der erwarteten 5 Prozent. Sein Rat lautet, die Stichprobe vorab festzulegen und bis zum Ende zu warten.
Vier weitere Punkte gehören zur Auswertung:
- Kein Ergebnis ist auch ein Ergebnis. Zeigt der Test keinen belastbaren Unterschied, bleibt die bisherige Version. Sie haben dann eine Vermutung ausgeschlossen.
- Segmente vorsichtig lesen. Wer nachträglich viele Teilgruppen betrachtet, findet häufig einen scheinbaren Gewinner. Segmente gehören vorab in die Planung.
- Gewinner dauerhaft umsetzen. Die siegreiche Version ersetzt die alte, die Testelemente werden entfernt.
- Ergebnis dokumentieren. Hypothese, Zeitraum, Zahlen und Entscheidung gehören in ein Protokoll, damit spätere Tests darauf aufbauen.